自大模型革命爆发以来,OpenAI(ChatGPT)与 Anthropic(Claude)已成为全球科技公司的底层大脑。然而,对于身处受限地域或构建大规模 AI Agent 服务的团队而言,API 接口的不稳定性和频繁封禁成为悬在头顶的达摩克利斯之剑。
一、AI 接口调用的三大典型困境
- “403 Forbidden / Access Denied”: 请求尚未到达模型推理后端,便被前置的 Cloudflare 或 OpenAI 边缘网关拦截。
- 账号连带风控与封号(Banned Account): 充值了数百美元 API Credits 的账号,突然收到违反使用条款的封禁邮件。
- 长连接与流式输出丢包(SSE Dropping): 当模型生成长文本时,普通的代理 IP 网络中途重置连接,导致客户端 Token 接收不完整。
2. IP 信誉与 AI 服务访问检查
OpenAI 和 Claude 必须遵守严格的合规政策,并防止黑客通过云端 VPS 组织撞库攻击或滥用免费额度。因此,它们接入了实时 IP 信誉情报数据库:
封锁核心:Hosting ASN 与滥用热度
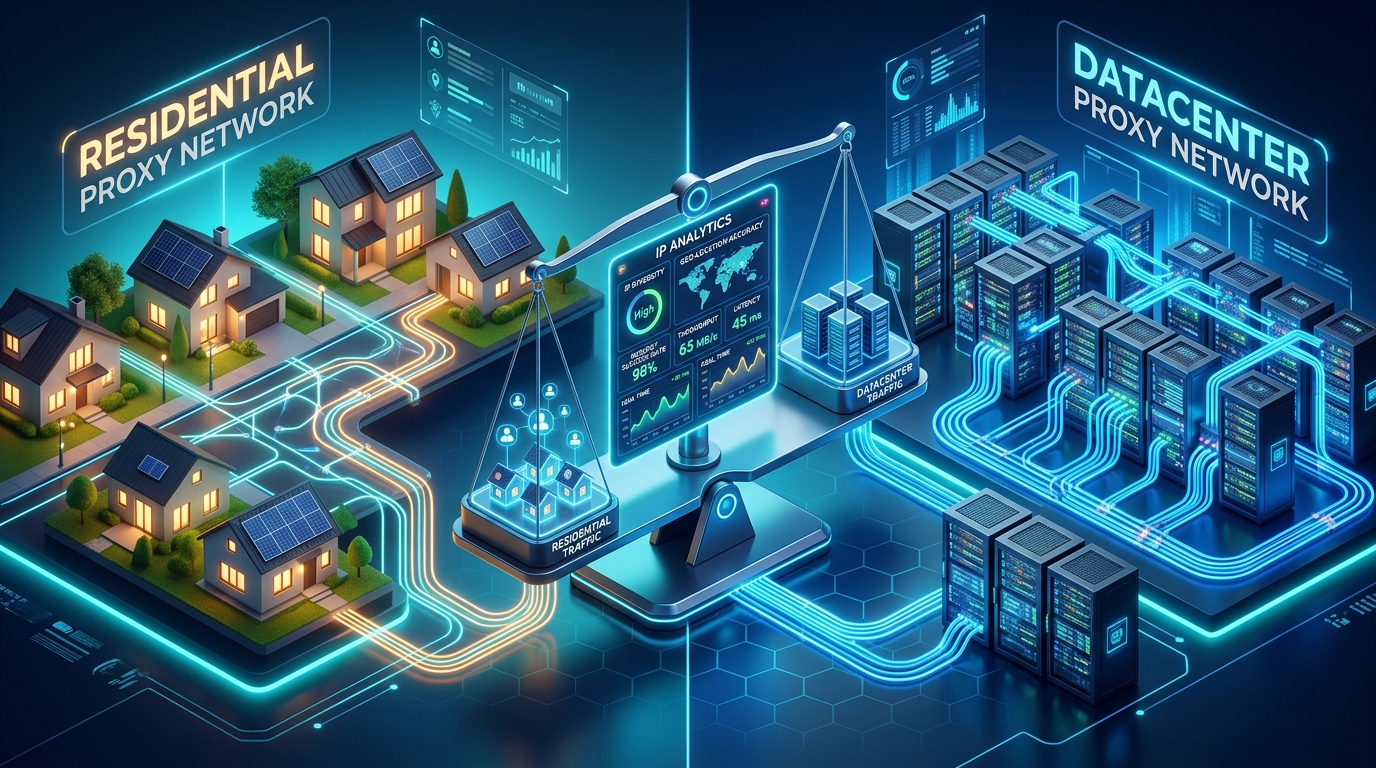
托管 ASN 或历史滥用记录可能影响 AI 服务的风险判断。服务还可能综合检查地区支持、账号权限及请求行为。
相反,独享静态住宅 IP可保持一致的网络身份,但其网络分类不能替代 AI 服务的地区规则和账号要求。
三、IP123 AI 专线网络的核心设计
针对严苛的生产环境,IP123 推出了 AI 专用代理 IP 通道:
- 100% 独享洁净出口: 每一条企业出口 IP 均为独立分配,绝无邻居污染。
- 选择 AI 服务支持的地区:查看代理 IP 可用地区,并用实际 API 任务测试首字延迟。延迟受路由、目标服务、模型和请求影响。
- 测试流式响应:在应用中配置超时与重连处理,再通过分配的静态端点测试较长的 SSE 响应。
四、解决流式响应 (SSE) 中断与重连机制
在工程落地中,开发者应在应用层配置合理的重试与超时:
- Connect Timeout 与 Read Timeout 分离: 连接超时设为 5 秒,读取超时放宽至 90 秒,允许大模型完成复杂思考(Reasoning)。
- 健康状态心跳探测: 本地常驻客户端每 60 秒向代理 IP 网关发送轻量探测包,确保 TCP 连接池活跃。
五、Node.js / Python 极简集成示范
以下 SDK 示例使用演示端点。请替换为后台的 IP、端口、用户名和密码,并核对当前 SDK 版本的代理 IP 配置方法。
使用独享静态 IP,为 AI 工作流保持固定连接地址。请针对目标服务测试连接与流式响应,代理 IP 连接异常时可联系客服。