LLM の学習データセット、EC の価格比較、評判のモニタリング、業界別 RAG ナレッジベースには、大量の Web データをリアルタイムで収集する仕組みが欠かせません。しかし現在、価値の高いサイトの 70% 以上が Cloudflare、Akamai、DataDome、Kasada などの企業向け WAF を導入しています。1 台のマシンで固定 IP を利用したり、User-Agent を変更したりするだけでは十分ではなく、クライアントのプロトコルフィンガープリントやリクエストの動作にも配慮が必要です。
1. ボット検知技術の進化
Web スクレイピングとその対策の発展を振り返ると、ボット検知技術は大きく 4 つの段階を経て進化してきました。
- 第 1 世代(静的な特徴による検出): HTTP ヘッダーの
User-Agent、Referer、Hostなどを確認し、IP ごとにリクエスト頻度を制限します(Rate Limiting)。 - 第 2 世代(動的な JS チャレンジ): 難読化した JavaScript を実行し、PoW(プルーフ・オブ・ワーク)を計算して、ヘッドレスブラウザーの特徴を検出します(
window.navigator.webdriver)。 - 第 3 世代(ネットワーク層とプロトコルのフィンガープリント): TLS ハンドシェイクの Client Hello に含まれる暗号スイート(JA3/JA4)と、HTTP/2 接続確立時の SETTINGS・WINDOW_UPDATE フレームの特徴を照合します。
- 第 4 世代(AI による行動分析とマルチモーダル認証): ジャイロセンサーやマウスの軌跡、キー入力間隔のエントロピー、Turnstile 認証、ネットワーク全体の IP 評価に基づく動的なブロックを組み合わせます。
2. TLS フィンガープリント:JA3/JA4 と HTTP/2 フレーム
開発者からは、「Python Requests にプロキシを設定しても、なぜ Cloudflare にすぐブロックされるのか」という疑問がよく寄せられます。その理由は、TLS Client Hello のフィンガープリントにあります。
Python が標準的に使用する urllib3 / OpenSSL は、TLS ハンドシェイク時に暗号スイート、拡張機能、楕円曲線グループの一覧を送信します。これらは実際の Google Chrome が送信するものと大きく異なります。
検出の手がかり:Python Requests の JA3 フィンガープリント
一般的な Python ライブラリの JA3 フィンガープリントは固定的で、ほぼすべての WAF が明確なクローラーの特徴としてブロックリストに登録しています。評価の良好な静的レジデンシャル IP を 10 万個保有していても、HTTP リクエストのデータ送信前に 403 Forbidden が返されたり、5 秒間のチャレンジが始まったりします。
TLS フィンガープリントに対応するため、最新のスクレイピングでは、curl_cffi や tls-client のように TLS Spoofing をサポートするネットワークライブラリを使い、Chrome や Firefox と 100% 同じ特性のハンドシェイクを再現します。
3. Cloudflare の 5 秒チャレンジと Turnstile
Cloudflare Turnstile は、従来の reCAPTCHA に代わって普及しつつあります。クライアント側で複雑な計算を目立たない形で実行し、接続元 IP のレピュテーションを総合的に評価します。
- クリーンな IP はスムーズに通過:Turnstile は複数の情報をもとに判定します。住宅 IP だけで認証成功が保証されるわけではないため、接続先でテストし、求められる確認に対応してください。
- データセンター IP には追加の認証: 既知のデータセンターの IP 範囲からアクセスすると、ブラウザーのフィンガープリントを再現していても、WAF が対話的なチェックボックスを 1 回以上表示し、自動収集の処理速度を大きく低下させます。
4. 高スループットの混合プロキシプールを設計する
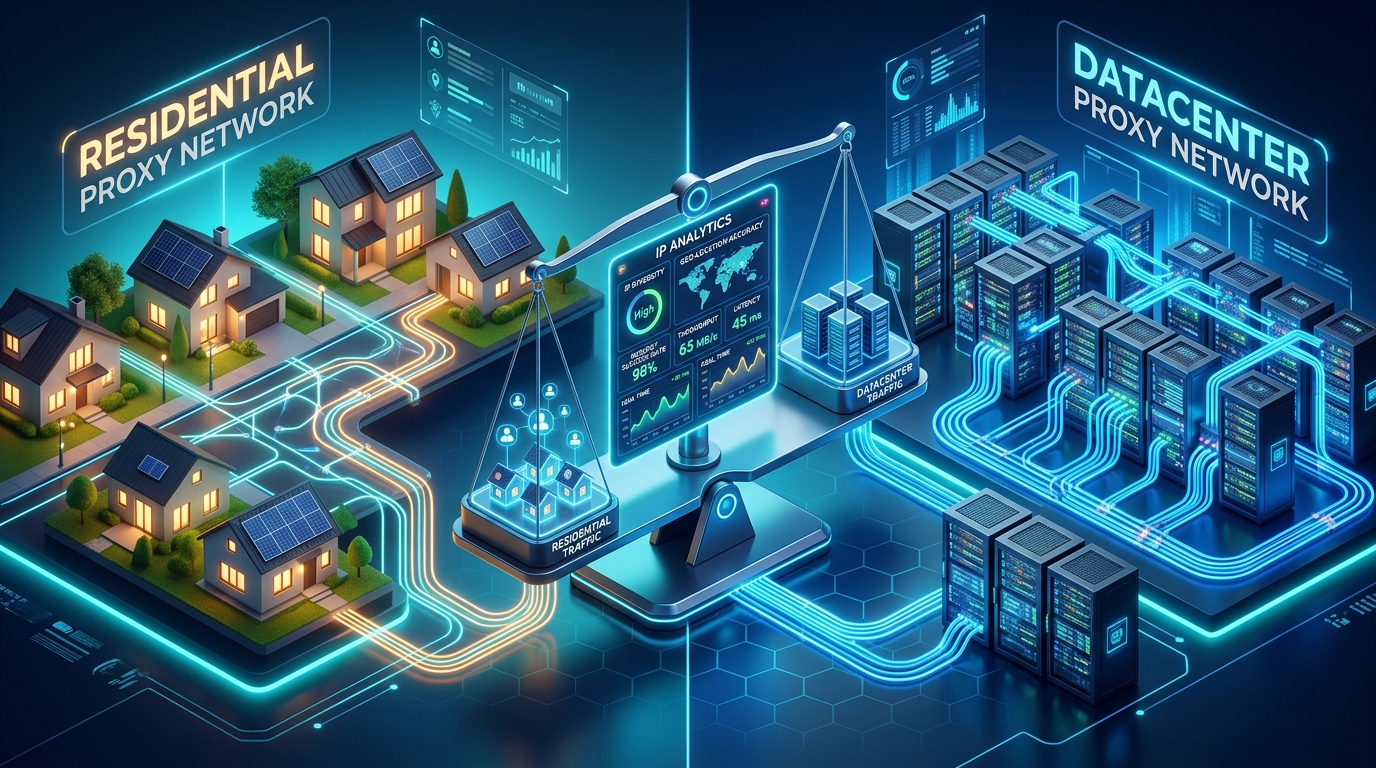
企業が大規模なデータ収集を行う場合、本番環境で成熟した構成は、すべての通信に高価なレジデンシャル IP を使うのではなく、通信の種類に応じて振り分ける 2 層のプロキシゲートウェイを採用します。
5. Python による自動化とセッション維持
以下は接続方法を示すサンプルで、curl_cffi と例示用の接続先を使用しています。実際のプロキシ接続先と対象 URL に置き換えてください。保護されたページへのアクセスを保証するコードではありません。
最新のデータ収集クラスターには、精度の高い TLS エミュレーションクライアントと、評価の良好なネイティブのレジデンシャルプロキシの組み合わせが必要です。IP123 のノードは、高い同時接続数で短時間接続と持続接続をサポートし、大規模なデータ収集に必要な可用性を提供します。